В этой статье разберём, почему SQL-запрос может тормозить даже с LIMIT 50, как разобраться в плане выполнения и подобрать индекс под свою задачу. Возьмём обычный список заказов и постепенно дойдём от поиска лишней работы до пагинации по дате и ID. Примеры будут для PostgreSQL и YDB, а в конце посмотрим, как эти знания пригодятся при работе с данными в Agnostic.
Почему LIMIT не спасает медленный SQL-запрос
Представьте, что вы сделали для мастерской список заказов. Пока в нём сотня записей, всё открывается быстро, и о запросе к базе как-то даже не думаешь. Но заказы копятся, сотрудник пытается найти давний ремонт, переходит подальше по страницам и начинает ждать. Вы открываете код, видите LIMIT 50 и сначала не понимаете, откуда вообще взялась задержка: на экран-то нужно вывести всего пятьдесят строк. Давайте посмотрим, что на самом деле просит у базы такой запрос.
SELECT *
FROM orders
WHERE customer_id = 'c_42'
ORDER BY created_at DESC, id DESC
LIMIT 50 OFFSET 10000;
Мы выбрали заказы клиента c_42, попросили поставить новые сверху, пропустить десять тысяч результатов и вернуть следующие пятьдесят. Причём сначала эти результаты нужно найти и упорядочить. Если подходящего индекса нет, база может перебрать немалую часть таблицы и отдельно отсортировать найденное. А SELECT * добавит к ответу все поля заказа, включая описание поломки и переписку, хотя сотрудник пока смотрит только на дату и сумму. Получается, короткая запись в коде поручает базе довольно много работы.
Чтобы понять, какая часть этой работы обходится дороже всего, начнём с плана выполнения в PostgreSQL. Затем подберём индекс и разберём, как похожее чтение устроено в YDB. При переходе между базами сама задача останется прежней, поэтому будет проще увидеть, где меняется только синтаксис, а где приходится учитывать другое устройство хранения. Если работаете с PostgreSQL, к разделу про YDB можно вернуться позже.
Для своих проверок возьмите копию данных или отдельную тестовую базу и сохраните исходный запрос вместе с параметрами. Дальше мы будем менять его по частям, чтобы после каждого шага было понятно, что именно повлияло на результат. Скорость придётся измерить на вашем объёме данных; на маленькой таблице ниже удобно проверить порядок строк и фильтры, но по ней нельзя судить, сколько времени займёт чтение рабочего списка.
EXPLAIN ANALYZE: как понять, куда уходит время
Когда запрос тормозит, хочется сразу добавить индекс и ещё раз нажать кнопку. Это вполне понятное желание, но без исходного плана потом трудно объяснить, почему стало быстрее или почему ничего не изменилось. EXPLAIN показывает, как PostgreSQL собирается выполнить запрос, а EXPLAIN ANALYZE запускает его и добавляет фактическое время и число строк. Если включить BUFFERS, в отчёте появится ещё и работа с блоками данных. Начнём с точной копии нашего запроса, сохранив и SELECT *, и OFFSET 10000.
EXPLAIN (ANALYZE, BUFFERS)
SELECT *
FROM orders
WHERE customer_id = 'c_42'
ORDER BY created_at DESC, id DESC
LIMIT 50 OFFSET 10000;
Допустим, в полученном плане вы видите цепочку Limit → Sort → Seq Scan. Разберём её как возможный вариант: Seq Scan читает таблицу и проверяет customer_id, Sort упорядочивает подходящие заказы, а Limit пропускает десять тысяч результатов и отдаёт следующие пятьдесят. Читать такую цепочку удобно снизу вверх, следуя за движением строк. Тогда становится понятно, почему маленькое число в верхнем узле ещё ничего не говорит об объёме работы под ним. После создания индекса сравним план того же запроса, а поля и способ перехода между страницами будем менять уже отдельно.
| Признак | Что выяснить |
|---|---|
| Seq Scan | Нужна ли большая часть таблицы или база перебирает много лишнего? Сам по себе Seq Scan не ошибка. |
| Index Scan / Index Only Scan | Совпадают ли условия с ключами индекса? Сколько строк приходится отсеять после чтения? |
| Sort | Можно ли получить нужный порядок из индекса? Не выходит ли сортировка на диск? |
| rows и actual rows | Близка ли оценка планировщика к факту? Большое расхождение — повод проверить статистику. |
| loops | Сколько раз выполняется узел? Маленькая операция, повторённая много раз, бывает дорогой. |
| Buffers | Как меняется объём работы с данными, а не только время одного запуска? |
Разглядывая числа в плане, держите рядом actual rows и loops. Если узел в среднем возвращает одну строку, но выполняется тысячу раз, за этой единицей стоят тысяча повторных обращений. Со временем похожая история: показатели повторяемого узла нужно читать вместе с числом повторов. При этом родительский узел уже включает работу дочерних, так что сумма всех времён в отчёте не даст длительность запроса. И не пытайтесь переводить cost в миллисекунды: планировщик использует собственные условные единицы, чтобы сравнивать варианты выполнения.
Заодно сравните ожидаемое число строк с фактическим. Если PostgreSQL рассчитывал найти несколько заказов, а нашёл половину таблицы, он мог выбрать план по устаревшей статистике; после большой загрузки данных её стоит проверить и при необходимости обновить командой ANALYZE orders. В BUFFERS показатель shared hit сообщает, сколько блоков удалось взять из кеша PostgreSQL, а shared read показывает чтение блоков в него. Последнее ещё может обслужить кеш операционной системы, поэтому считать каждое shared read обращением к физическому диску было бы неверно.
При использовании EXPLAIN ANALYZE имейте в виду, что исследуемый запрос действительно выполнится. С нашим SELECT это чтение, а с INSERT или UPDATE команда изменит данные. Само профилирование тоже занимает время, зато передачу результата по сети такое измерение не включает. Поэтому сохраните несколько запусков с одинаковыми параметрами и отдельно посмотрите, сколько открывается весь экран приложения. Сбрасывать кеш рабочей базы ради чистоты эксперимента не нужно: гораздо полезнее сравнивать запросы в одинаковых, понятных вам условиях.
Индексы SQL: что ускоряют и почему их нельзя добавлять на всё
Теперь вернёмся к заказам и подумаем, чем может помочь индекс. Если квитанции мастерской лежат в порядке поступления, ради всех ремонтов Петрова придётся перелистать всю стопку. Можно завести рядом указатель, в котором квитанции собраны по клиенту, а внутри каждого клиента расположены по дате. Тогда вы сразу знаете, какую часть смотреть и где искать последние заказы. Индекс в базе устроен сложнее такой тетради, но смысл дополнительной структуры похож: заранее организовать данные для нужного способа чтения.
У этого удобства есть цена. С появлением нового заказа нужно пополнить и основную стопку, и указатель, а если указателей несколько, обновлять придётся каждый. В базе индексы тоже занимают место и требуют работы при изменении данных. Поэтому начинаем с запроса, которым люди действительно пользуются, и выясняем, какая структура поможет именно ему. Для разных задач базы предлагают разные виды индексов; в таблице ниже собраны несколько ориентиров, чтобы знакомая команда из PostgreSQL случайно не превратилась в рецепт для любой СУБД.
| Задача | PostgreSQL | YDB: строковые таблицы |
|---|---|---|
| Равенство, диапазон, порядок | Часто подходит B-tree; порядок ключей выбирают под запрос. | Путь по primary key или подходящему вторичному индексу. |
| Несколько полей в фильтре | Составной индекс; иногда оптимизатор объединяет отдельные индексы. | Составной ключ индекса и ограничения на его ведущие колонки. |
| JSON, массивы, полнотекстовый поиск | Для поддерживаемых операторов применяют GIN и другие специальные решения. | Возможности и синтаксис проверяют отдельно; PostgreSQL GIN сюда не переносится. |
| Большая физически упорядоченная таблица | BRIN может быть полезен для подходящего распределения данных. | Это отдельная модель хранения и партиционирования, а не аналог команды CREATE INDEX USING brin. |
После создания индекса в плане всё равно может остаться Seq Scan, и это ещё не повод спорить с планировщиком. Когда запросу нужна почти вся таблица, прочитать её последовательно бывает дешевле, чем ходить за строками через индекс. На небольшой таблице такое решение тоже вполне разумно. Разбираться стоит в том, сколько лишних данных обрабатывается и почему выбран этот путь, иначе легко потратить время на получение красивой надписи Index Scan без пользы для экрана.
Как подобрать составной индекс PostgreSQL для списка заказов
Для нашего списка указатель получается довольно естественным. Сначала собираем вместе заказы одного customer_id, внутри них располагаем created_at по убыванию, а заказы с одинаковым временем различаем по id. Последний ключ понадобится и для устойчивой сортировки, и чуть позже для перехода к следующей странице. Создадим отдельную таблицу с таким индексом, добавим несколько строк и сузим запрос до заказов за сентябрь. Для списка оставим только те поля, которые он показывает.
CREATE TABLE orders (
  id text PRIMARY KEY,
  customer_id text NOT NULL,
  created_at timestamptz NOT NULL,
  total numeric(12, 2)
);

CREATE INDEX orders_customer_created_id_idx
ON orders (customer_id, created_at DESC, id DESC);INSERT INTO orders (id, customer_id, created_at, total) VALUES
('o_107', 'c_42', '2026-09-29 10:00:00+00', 3500),
('o_106', 'c_42', '2026-09-29 10:00:00+00', 2000),
('o_105', 'c_42', '2026-09-29 10:00:00+00', 4700),
('o_104', 'c_42', '2026-09-28 09:00:00+00', 1200),
('o_103', 'c_42', '2026-10-01 00:00:00+00', 2800),
('o_102', 'c_7', '2026-09-29 11:00:00+00', 1900);SELECT id, created_at, total
FROM orders
WHERE customer_id = 'c_42'
AND created_at >= TIMESTAMPTZ '2026-09-01 00:00:00+00'
AND created_at < TIMESTAMPTZ '2026-10-01 00:00:00+00'
ORDER BY created_at DESC, id DESC
LIMIT 50;В запросе месяц начинается с 1 сентября включительно и заканчивается перед 1 октября. Так не приходится угадывать последнюю долю секунды сентября: всё, что уже относится к октябрю, за правую границу не проходит. Здесь обе границы заданы в UTC. Условие сравнивает исходное значение created_at с диапазоном; если вместо этого обернуть каждую строку в date_trunc, для эффективного чтения может понадобиться другой индекс или другой план.
На добавленных строках ответ легко проверить руками: сначала o_107, затем o_106, o_105 и o_104. Заказ o_103 не попал в список, потому что создан уже в октябре, а o_102 принадлежит другому клиенту. Такой небольшой набор удобен тем, что потерявшуюся или лишнюю строку видно сразу. Однако сравнивать на шести строках скорость бессмысленно, и выбранный PostgreSQL последовательный просмотр здесь будет нормальным решением. Если повторяете пример, создавайте новую таблицу; повторная вставка тех же ID в уже заполненную даст конфликт первичного ключа.
Когда смысл запроса проверен, можно вернуться к данным рабочего масштаба и сравнить чтения, сортировку и время. Наш индекс подобран под конкретное сочетание клиента и дат, но отсюда не следует, что без условия на первую колонку любой составной индекс бесполезен. PostgreSQL умеет читать их разными способами, в том числе использовать описанный в версии 18 skip scan. Для начала достаточно проверить один понятный вариант под свой частый запрос, а к более сложным способам чтения обращаться, когда план покажет необходимость.
Оптимизация запросов YDB: вторичный индекс и VIEW
В YDB мы можем решить ту же задачу, хотя команды и некоторые детали будут другими. У строковой таблицы данные организованы по первичному ключу: id удобен, когда нужно открыть конкретный заказ по номеру. Но сотрудник смотрит все заказы клиента за месяц, и одного номера заказа для такого поиска мало. Добавим вторичный индекс по customer_id и created_at. Даже если база работает в режиме Serverless и вам не приходится обслуживать серверы, выбирать подходящий путь чтения всё равно нужно.
CREATE TABLE `orders` (
  id Utf8 NOT NULL,
  customer_id Utf8 NOT NULL,
  created_at Timestamp NOT NULL,
  total Decimal(22, 9),
  PRIMARY KEY (id)
);

ALTER TABLE `orders`
  ADD INDEX `by_customer_created` GLOBAL SYNC
  ON (customer_id, created_at);
Если таблица уже заполнена, дайте новому индексу достроиться перед проверкой запроса. Надпись GLOBAL SYNC иногда сбивает с толку: SYNC относится к согласованному обновлению таблицы и индекса при дальнейших записях. Первоначальное построение по существующим данным при этом может занять время. Когда индекс готов, укажем его в запросе через VIEW и снова выберем сентябрьские заказы клиента.
SELECT id, created_at, total
FROM `orders` VIEW `by_customer_created`
WHERE customer_id = Utf8("c_42")
  AND created_at >= Timestamp("2026-09-01T00:00:00Z")
  AND created_at <  Timestamp("2026-10-01T00:00:00Z")
ORDER BY customer_id DESC, created_at DESC, id DESC
LIMIT 50;
Через VIEW мы явно направили чтение в by_customer_created. В ключ этого индекса также входит первичный ключ таблицы, то есть id, поэтому он участвует в порядке строк с одинаковой датой. Все поля в ORDER BY идут в одном направлении; customer_id при этом фиксирован условием, так что результат остаётся списком одного клиента. А вот total в ключе нет, и за суммой заказа базе может потребоваться обратиться к основной таблице. Это один из случаев, когда наличие индекса само по себе ещё не рассказывает обо всей работе запроса.
Обратите внимание и на значения справа от знаков сравнения. YQL различает Utf8 для текста и Timestamp для времени, поэтому PostgreSQL-запрос с его приведениями типов сюда целиком не переносится. Мы сохраняем смысл фильтра и сортировки, а запись подстраиваем под другую базу. Автоматический выбор индекса тоже зависит от версии и настроек YDB; надёжнее проверить фактический план, чем решить, что после CREATE INDEX сервер обязательно начнёт читать нужным нам способом.
| Приём | Что сохранить | Что проверить отдельно |
|---|---|---|
| Индекс под запрос | Фильтр, диапазон и порядок чтения. | DDL, способ выбора индекса и его готовность. |
| Параметры | Пользовательские значения передают параметрами. | Типизацию и API своего драйвера. Значения в статье фиксированы для примера. |
| План выполнения | Сколько данных обрабатывается и где сортировка. | Названия узлов и инструмент получения статистики. |
| Пагинация | Однозначный порядок и граница следующей страницы. | NULL, состав ключа, направление сортировки и поведение при изменении данных. |
# План без выполнения
ydb -p learning sql --explain -f query.yql

# Выполнение SELECT со статистикой
ydb -p learning sql --stats full -f query.yql
Команды выше выполняются в YDB CLI с заранее настроенным профилем learning для вашей базы. В плане смотрите, читает ли запрос таблицу целиком, ограничивается диапазоном или находит строки по ключу, и остаётся ли отдельная сортировка. В зависимости от версии эти операции могут называться TableFullScan, TableRangeScan, TablePointLookup и Sort/TopSort. Затем сопоставьте план с числом прочитанных строк и байтов. Это проверка через инструменты самой YDB; к работе с коллекциями Agnostic вернёмся отдельно ниже.
OFFSET или keyset: как ускорить следующие страницы
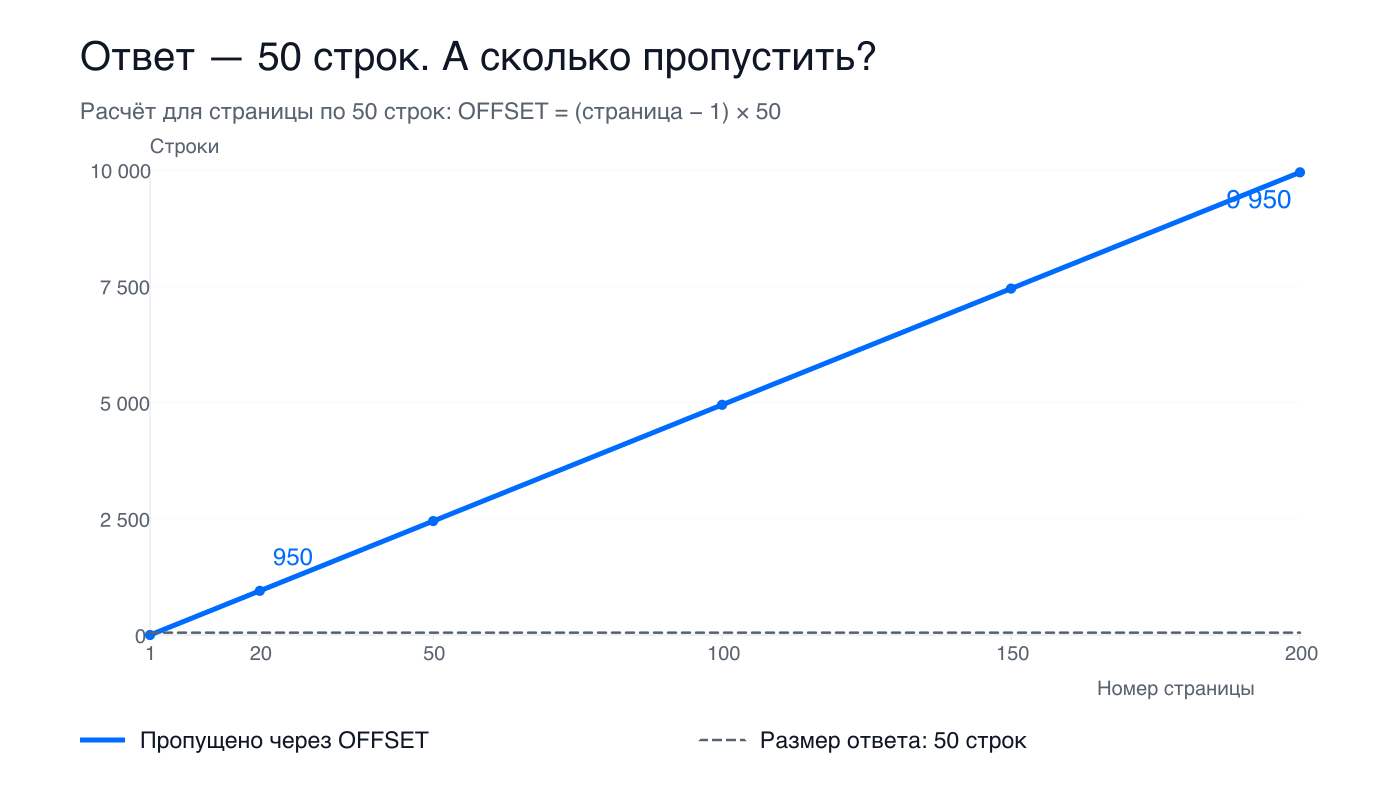
С индексом мы помогли базе находить нужные заказы, но OFFSET 10000 всё ещё просит пропустить десять тысяч результатов. Для перехода прямо на седьмую страницу это понятная модель, особенно если список небольшой. Если же человек нажимает «Показать ещё», нам уже известно, где закончилась предыдущая порция. Можно запомнить дату и ID последнего показанного заказа и попросить следующие строки после этой границы. Такой способ называется keyset, а курсор приложения обычно хранит или кодирует значения границы вместе с параметрами запроса.
SELECT id, created_at, total
FROM orders
WHERE customer_id = 'c_42'
  AND created_at >= TIMESTAMPTZ '2026-09-01 00:00:00+00'
  AND created_at <  TIMESTAMPTZ '2026-10-01 00:00:00+00'
  AND (created_at, id) < (
    TIMESTAMPTZ '2026-09-29 10:00:00+00',
    'o_105'
  )
ORDER BY created_at DESC, id DESC
LIMIT 50;SELECT id, created_at, total
FROM `orders` VIEW `by_customer_created`
WHERE customer_id = Utf8("c_42")
AND created_at >= Timestamp("2026-09-01T00:00:00Z")
AND created_at < Timestamp("2026-10-01T00:00:00Z")
AND (created_at, id) < (
Timestamp("2026-09-29T10:00:00Z"),
Utf8("o_105")
)
ORDER BY customer_id DESC, created_at DESC, id DESC
LIMIT 50;В обоих запросах дата и id взяты из последней строки предыдущей страницы. Сентябрьский диапазон и customer_id мы тоже сохранили: иначе, продолжая листать сентябрь, человек однажды получит август или чужие заказы. В нашей схеме ключи сортировки имеют NOT NULL, поэтому сравнение не приходится отдельно согласовывать с пустыми значениями. Пара из даты и уникального id позволяет точно указать место в списке, даже когда сразу несколько заказов созданы в один момент.
Это удобно увидеть на трёх заказах из примера. Допустим, страница вмещает два: сначала вы получите o_107 и o_106 с одинаковым временем. Если следующей странице передать только дату и потребовать записи строго раньше неё, заказ o_105 потеряется, потому что его время такое же. Если передать дату вместе с id последней показанной строки o_106, чтение продолжится с o_105. Сам ID здесь текстовый и сравнивается лексикографически; хронологию задаёт created_at, а ID лишь помогает однозначно расставить совпавшие даты.
Заодно можно обойтись без отдельного подсчёта всех заказов, если экрану достаточно знать, есть ли продолжение. Запросите 51 строку, покажите первые 50, а оставшуюся используйте как признак следующей страницы. Границу при этом берите из последней показанной строки, иначе лишнюю запись можно случайно пропустить. Этот приём подходит для собственного приложения, которому не требуется точный общий счётчик. И помните, что наличие следующей страницы известно на момент запроса: пока человек читает список, данные могут измениться.
| Сценарий | Подход | Компромисс |
|---|---|---|
| Маленький список, переход к странице 7 | LIMIT / OFFSET | Просто, но стоимость пропуска растёт с глубиной. |
| Лента или кнопка «Показать ещё» | Keyset / cursor | Нужны устойчивый порядок и подходящий путь чтения; нет простого прыжка к номеру страницы. |
| Нужен точный общий счётчик | Отдельно измерить COUNT(*) | Курсор ускоряет получение страницы, но не отменяет стоимость подсчёта всех совпадений. |
С keyset всё равно стоит посмотреть план: неудачный индекс или дополнительный фильтр могут заставить базу читать намного больше пятидесяти строк. Ещё этот способ не замораживает список на всё время просмотра. Если между запросами у заказа изменится поле сортировки, он может переместиться относительно уже пройденной границы. Для обычной ленты это один набор требований, для выгрузки отчёта с гарантированно неизменным составом уже другой; заранее договоритесь, нужны ли вам единый снимок и защита от пропусков или повторений.
SELECT *, N+1 и COUNT(*): работа, которую легко не заметить
Даже удачный план одного запроса иногда оставляет экран медленным, потому что рядом выполняется другая работа. Начните с полей ответа: SELECT * вполне может принести большие описания или JSON, хотя в строке списка показываются только id, created_at и total. Когда вы перечисляете нужные поля явно, уменьшается объём ответа и проще понять, от каких данных зависит экран. Сокращение чтения из самого хранилища нужно проверять отдельно по плану и статистике: маленький ответ не всегда означает, что база мало прочитала.
Затем посчитайте, сколько запросов вызывает одно открытие страницы. Например, приложение сначала получает пятьдесят заказов, а потом для каждого отдельно запрашивает имя клиента. Так возникает N+1: один запрос списка и ещё N запросов к его строкам. При небольшой таблице задержку иногда создают уже сами сетевые обращения. Можно загрузить клиентов одним пакетом по набору ID или соединить нужные данные через JOIN, а после изменения снова измерить открытие всего экрана.
При замене нескольких запросов на JOIN проверьте не только время. Условие на правую таблицу, оказавшееся в WHERE после LEFT JOIN, может исключить заказы без совпадения, хотя раньше они отображались. Связь «один ко многим», наоборот, способна размножить строки. Поэтому после такой переделки полезно взять заказ без связанных данных и заказ с несколькими связанными записями и убедиться, что оба по-прежнему показаны как задумано.
Остаётся счётчик рядом со списком. Пользователь видит пятьдесят строк, а приложение заодно считает все подходящие заказы через COUNT(*); при сложном фильтре именно подсчёт может занимать больше времени. Для ленты часто достаточно кнопки продолжения, тогда как в отчёте точное число действительно нужно. Обсудите это с тем, кто пользуется экраном: если он сверяет количество заказов, приблизительное значение вместо точного будет уже изменением поведения, а не незаметной технической оптимизацией.
В YDB Serverless все эти обращения отражаются и на расходе ресурсов. RU учитывают вычисления и работу с данными по правилам YQL, поэтому вместе со временем полезно смотреть чтения и CPU. Небольшой JSON на выходе может стоить заметно больше, чем кажется по его размеру. Расчётный график выше показывает только количество пропускаемых строк: перевести его напрямую в RU или рубли нельзя. Пользовательский тариф Agnostic при этом отдельно устроен от тарифа Яндекс Клауда на YDB.
Как применить это к данным приложения в Agnostic
Если данные вашего приложения находятся в Agnostic, за пользовательскими записями там стоит YDB Serverless. Но повседневная работа начинается в разделе «Данные»: вы выбираете проект и окружение, настраиваете фильтр и представление. Выполнять приведённый выше DDL для коллекции не требуется. От разбора SQL здесь пригодится способ рассуждать: какие заказы нужны экрану, что задаёт их порядок, какие поля он читает и ради чего каждый раз считает общее количество. С этого и начните диагностику конкретного списка.
01Опишите один медленный сценарий
Начните со списка заказов выбранного клиента за месяц, в котором новые идут первыми. Запишите размер страницы и поля, которые видит сотрудник, затем выберите проект и окружение для проверки. Так у следующего изменения будет понятная область работы.
02Проверьте фильтр и представление
Посмотрите, ограничивает ли фильтр выборку нужными записями и сохраняется ли однозначный порядок при одинаковых датах. Для перехода дальше в коде приложения используйте курсор, который возвращает API: его внутреннее устройство не нужно разбирать или воспроизводить самостоятельно.
03Подберите индекс под повторяющийся запрос
Если сервер поддерживает управляемые индексы, подготовьте изменение через Agnostic CLI: сначала data plan и проверка плана, затем data prepare и применение в интерфейсе. Дождитесь завершения операции перед измерением. Команды DDL из раздела про самостоятельную YDB здесь не подходят: коллекции Agnostic имеют собственный порядок управляемых изменений.
04Сравните весь экран до и после
Повторите открытие первой и глубокой страницы несколько раз с одинаковыми данными и фильтрами. Для такого списка Agnostic также получает точное число совпадений, даже когда страницы читаются по курсору. Если список по-прежнему открывается медленно, отдельно посмотрите, сколько времени занимает этот подсчёт.
Работай в выбранном проекте и окружении Agnostic.
Начни с диагностики, без изменения ресурсов и кода.
Если работаешь из Cursor, Codex или Claude Code,
сначала проверь подключение Agnostic MCP.
Если подключения нет, попроси инструкцию из меню MCP
выбранного проекта и окружения, покажи план настройки
и дождись моей авторизации. После подключения прочитай
контекст, назови проект, окружение и доступные действия.

Для анализа кода используй workspace выбранного проекта,
полученный через Agnostic CLI; если его нет, помоги получить.

Проверь медленный список заказов этого приложения.
Нужны заказы одного клиента за месяц,
сортировка по дате и id, страницы по 50 записей.

Найди лишние поля и повторные запросы на каждую строку.
Проверь подходящий путь чтения и цену точного счётчика.
Если нужен индекс, предложи план изменения в Agnostic
и объясни его цену при записи. Применение обсудим отдельно.
В плане сохрани результат запроса, права доступа и фильтры.
Предложи воспроизводимое сравнение всего сценария до и после.
Когда агент предложит более узкий запрос или индекс, проверьте, что он сохранил правила доступа. В нашем примере customer_id ограничивает выборку для экрана, а право пользователя видеть заказы этого клиента сервер проверяет отдельно. Передать в браузер всю таблицу и отфильтровать её там было бы особенно неудачным способом ускорения: лишние контакты уже окажутся у пользователя, даже если интерфейс их не нарисует.
Как проверить изменение перед выпуском
Перед выпуском соберите результаты в одну заметку, чтобы через неделю не выяснять заново, что вы сравнивали. Для этого пригодятся исходный запрос, параметры, выбранное окружение и показатели до и после. Если записать только самое удачное время, повторить результат будет трудно: база могла работать с другим кешем или нагрузкой. Ниже перечислено, что стоит сохранить вместе с изменением.
| Показатель | Как сравнивать |
|---|---|
| Результат | Те же строки, порядок, поля и правила доступа. |
| Время сценария | Несколько повторений; при достаточной выборке — медиана и p95, одинаковая нагрузка. |
| Работа базы | Прочитанные строки/байты, сортировка, обращения к данным и фактический план. |
| Работа приложения | Количество запросов на экран, объём ответа, первая и глубокая страницы. |
| Цена индекса | Время и ресурсы записи, место, готовность и актуальность индекса. |
Для первого разбора достаточно одного экрана, который действительно мешает работе. Запишите его запрос страницы, подсчёт заказов и дополнительные обращения, сохраните исходные показатели и измените одну вещь. После повторного запуска проверьте не только длительность, но и состав списка: те ли заказы остались, совпали ли даты и суммы, работает ли переход дальше. Сохранённый результат станет отправной точкой для следующей правки, и при ошибке будет понятно, к какому состоянию вернуться.
Частые вопросы
Почему запрос медленный, хотя стоит LIMIT 50?
LIMIT ограничивает только количество строк в ответе. Чтобы их получить, база может сначала прочитать большой объём данных, отфильтровать и отсортировать его, а затем пропустить OFFSET. Начните с плана этого запроса и проверьте, не ждёт ли экран ещё и отдельный COUNT(*).
Почему PostgreSQL не использует созданный индекс?
Возможно, индекс не подходит фильтру или порядку чтения, а возможно, запросу нужна почти вся таблица и последовательный просмотр обходится дешевле. Сравните оценку строк с фактическим результатом в EXPLAIN ANALYZE и проверьте статистику. Сам по себе Seq Scan ещё не говорит об ошибке.
Какой индекс SQL лучше: один составной или несколько отдельных?
Начните с запроса, который нужно ускорить. Если в нём постоянно сочетаются один фильтр и сортировка, составной индекс часто оказывается удобным кандидатом. Отдельные индексы могут пригодиться другим запросам, а PostgreSQL иногда объединяет их при чтении; окончательный выбор стоит сделать по планам и цене обновления индексов при записи.
Всегда ли keyset быстрее OFFSET?
Keyset убирает необходимость пропускать предыдущие строки результата и часто полезен для глубоких страниц. Но неподходящий индекс, сортировка, дополнительные фильтры и точный общий счётчик могут оставить много работы. Для небольшого списка с переходом к произвольной странице OFFSET может быть достаточен.
Можно ли перенести запрос PostgreSQL в YDB без изменений?
Смысл фильтра и сортировки можно сохранить, но YQL использует другие типы, приведения и синтаксис, а индексы работают по своим правилам. Поэтому после переноса нужно проверить и план, и полученные строки, особенно порядок и пустые значения. Для этого в статье один список разобран в обеих базах.
Можно ли выполнить эти CREATE INDEX и EXPLAIN прямо в Agnostic?
Эти команды выполняются в вашей собственной PostgreSQL или YDB. В Agnostic работа начинается с фильтров, представлений и курсоров, а поддерживаемые изменения индексов проходят через отдельный план. Наличие YDB внутри платформы не означает, что в разделе «Данные» доступна такая же SQL-консоль или EXPLAIN.
Источники
- PostgreSQL: EXPLAIN и фактическое выполнение
- PostgreSQL: как читать план запроса
- PostgreSQL: составные индексы
- PostgreSQL: индекс и ORDER BY
- PostgreSQL: типы индексов
- PostgreSQL: LIMIT и OFFSET
- YDB: вторичные индексы
- YDB: создание и построение индекса
- YDB: типы данных YQL
- YDB: структура плана запроса
- YDB: постраничный вывод
- YDB CLI: выполнение запроса и статистика
- Yandex Cloud: Serverless и Dedicated
- Yandex Cloud: как оцениваются ресурсы YQL-запроса